

Serverless Inference
Serverless Inference は、W&B Weave と OpenAI 準拠 API を通じて、オープンソース基盤モデルにアクセスできるようにする機能です。このガイドでは、API と Weave UI から Serverless Inference を呼び出す方法、およびそれらの Call を Weave でトレース、評価、監視する方法について説明します。Serverless Inference では、次のことができます。- ホスティングプロバイダーに登録したりモデルをセルフホストしたりすることなく、AI アプリケーションやエージェントを開発する。
- Weave Playground でサポート対象モデルを試す。
このガイドでは、次の情報を提供します。
前提条件
API または Weave UI を介して Serverless Inference サービスにアクセスするには、事前に以下を用意する必要があります。- W&B アカウント。アカウントを作成してください。
- W&B APIキー。User Settings で APIキーを作成してください。
- W&B プロジェクト。
- Python 経由で Inference サービスを使用する場合は、Python 経由で API を使用するための追加の前提条件を参照してください。
Python 経由で API を使用するための追加の前提条件
Python 経由で Inference API を使用するには、まず一般的な前提条件を完了してください。次に、ローカル環境にopenai と weave ライブラリをインストールしてください。openai ライブラリは、Inference エンドポイントの呼び出しに使用する OpenAI 互換クライアントを提供し、weave ライブラリはそれらの Call をトレースして評価できるようにします。
LLM アプリケーションのトレースに Weave を使用する場合にのみ、
weave ライブラリが必要です。Weave の利用を開始する方法については、Weave クイックスタートを参照してください。Weave で Serverless Inference サービスを使用する方法を示す API の使用例については、API の使用例を参照してください。API 仕様
以下のセクションでは、API 仕様に関する情報と API の利用例を紹介します。これにより、独自のアプリケーションやスクリプトから Inference サービス をプログラムで呼び出すことができます。エンドポイント
以下のエンドポイントから Inference サービスにアクセスしてください。利用可能な method
Inference サービスは、以下の API method をサポートします。Chat completions
利用可能な主要な API method は/chat/completions です。これは、サポートされるモデルにメッセージを送信して補完を受け取るための OpenAI 互換の Request 形式をサポートします。Weave で Serverless Inference サービスを使用する方法を示す使用例については、API の使用例を参照してください。
チャット補完を作成するには、次が必要です。
- Inference サービスのベース URL
https://api.inference.wandb.ai/v1 - W&B APIキー
<your-api-key> - W&B entity 名とproject名
<your-team>/<your-project> - 使用するモデルの ID。以下のいずれかです。
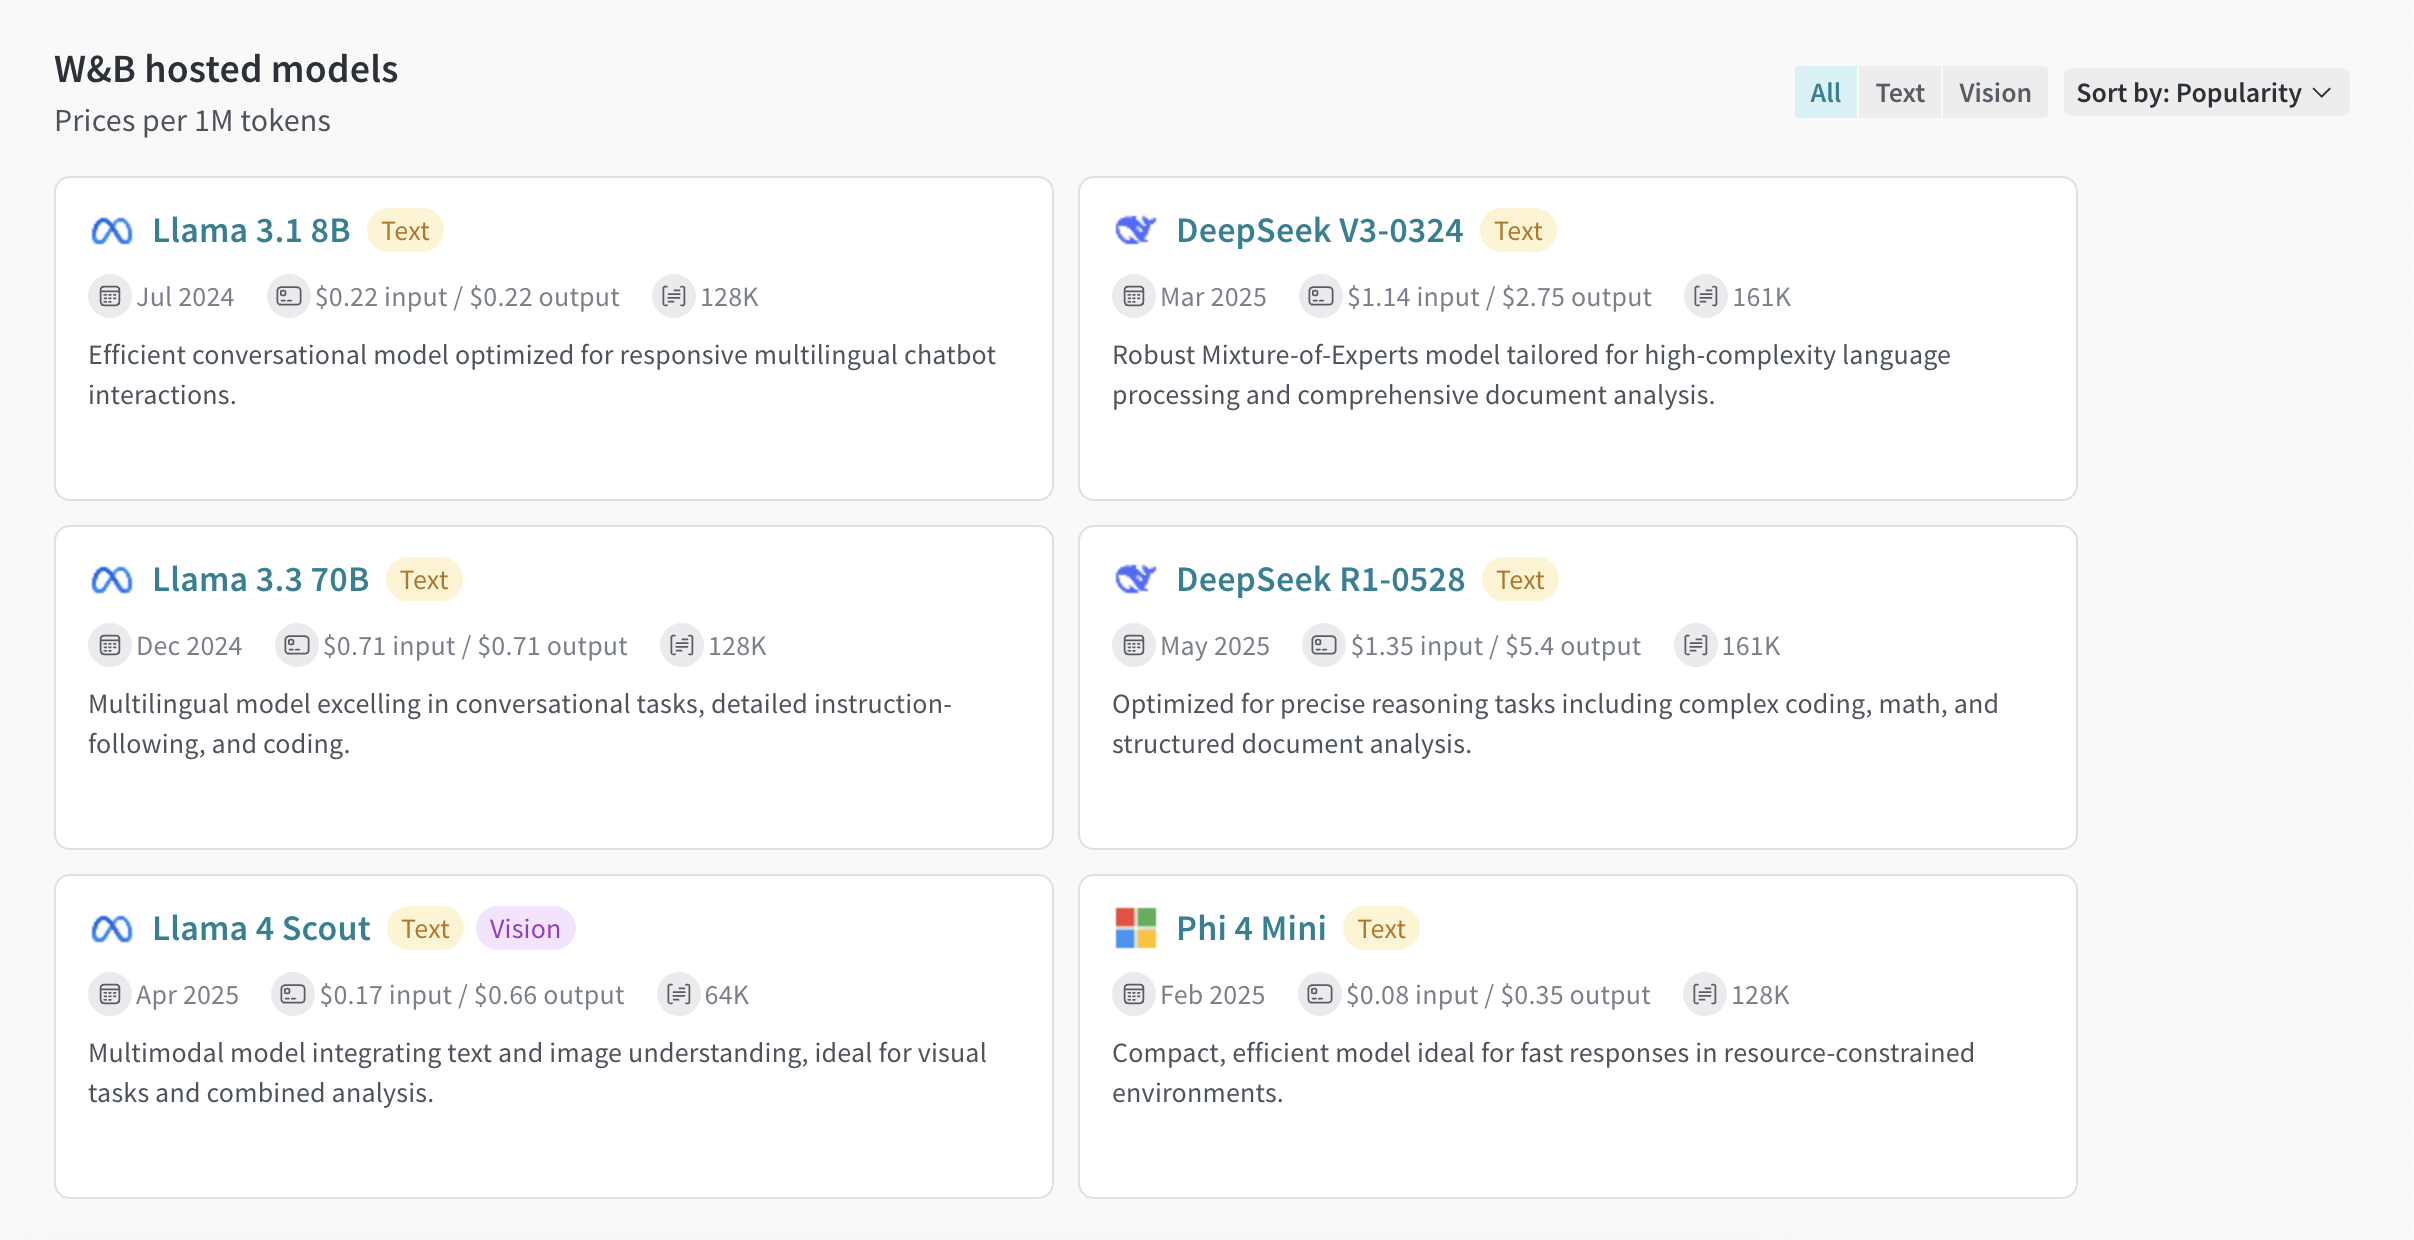
meta-llama/Llama-3.1-8B-Instructdeepseek-ai/DeepSeek-V3-0324meta-llama/Llama-3.3-70B-Instructdeepseek-ai/DeepSeek-R1-0528meta-llama/Llama-4-Scout-17B-16E-Instructmicrosoft/Phi-4-mini-instruct
- Bash
- Python
サポート対象モデルを一覧表示
APIを使用して、利用可能なすべてのモデルとそのIDをクエリします。これは、モデルを動的に選択したり、環境で利用可能なモデルを確認したりするのに役立ちます。- Bash
- Python
使用例
以下のセクションでは、Weave で Serverless Inference を使用する方法を示す、いくつかの例を紹介します。まずは基本例で 1 回のモデル呼び出しをトレースし、次に応用例で複数のモデルを評価して比較します。基本例: Weave で Llama 3.1 8B をトレースする
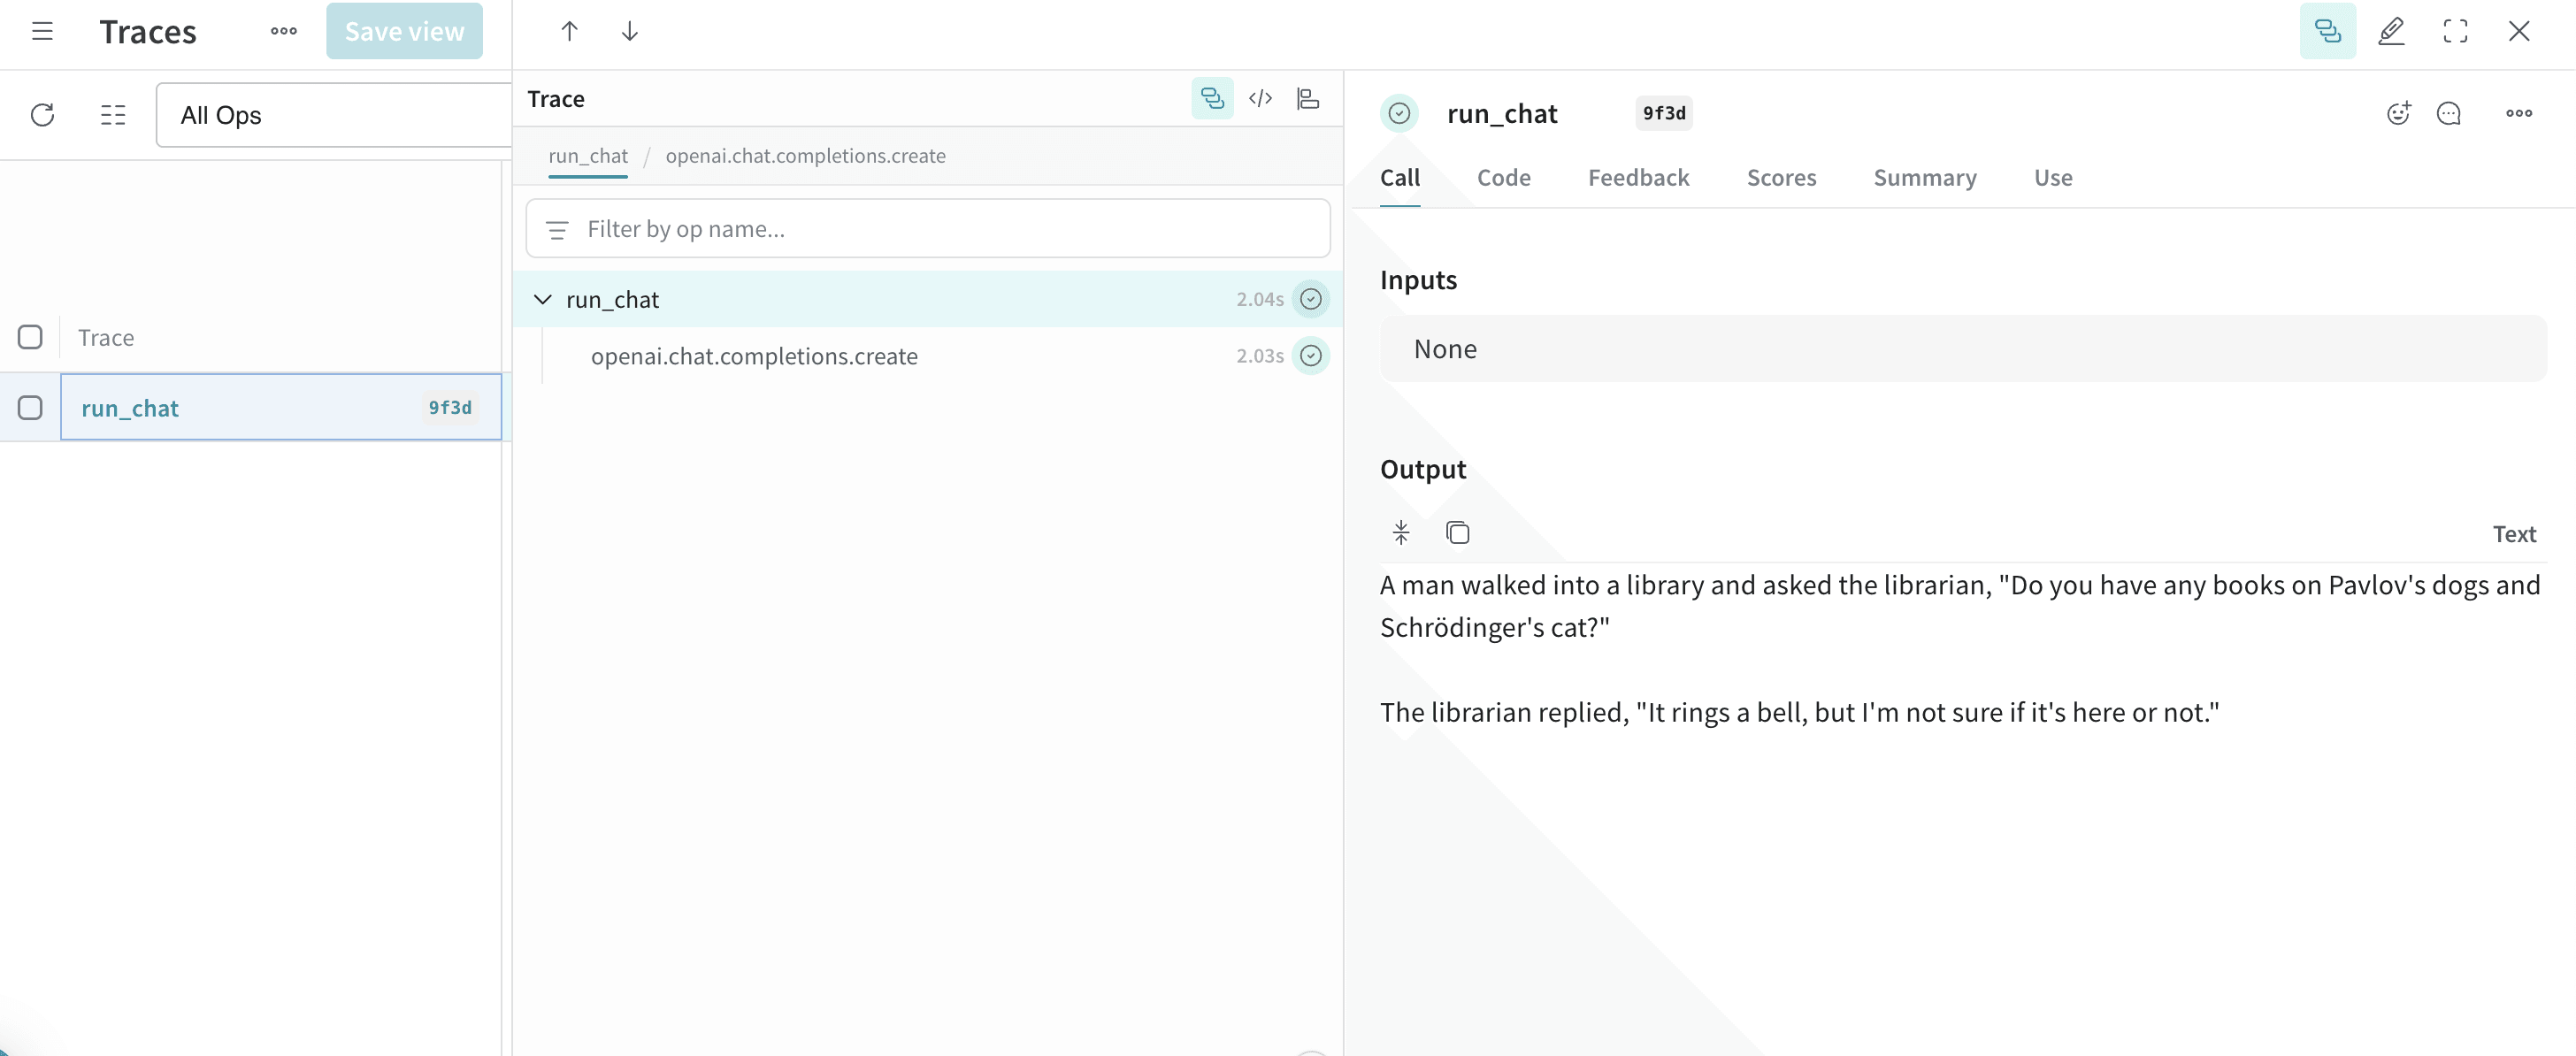
以下の Python コードサンプルは、Serverless Inference API を使用して Llama 3.1 8B モデルにプロンプトを送信し、その呼び出しを Weave でトレースする方法を示しています。トレースを使用すると、LLM の呼び出しの完全な入出力を取得し、パフォーマンスを監視し、Weave UI で結果を分析できます。 この例では、次のことを行います。- OpenAI 互換クライアントを使用して chat completion リクエストを行う、
@weave.op()でデコレートされた関数run_chatを定義します。 - Weave はトレースを記録し、それらを W&B の entity とproject
project="<your-team>/<your-project>"に関連付けます。 - Weave はこの関数を自動的にトレースし、その入力、出力、レイテンシー、メタデータ (モデル ID など) をログします。
- 結果はターミナルに出力され、トレースは指定したproject配下の https://wandb.ai の Traces タブに表示されます。
https://wandb.ai/<your-team>/<your-project>/r/call/01977f8f-839d-7dda-b0c2-27292ef0e04g) をクリックします。あるいは、次の手順でも確認できます。
- https://wandb.ai にアクセスします。
- Traces タブを選択して、Weave のトレースを表示します。
高度な例: Inference サービス で Weave の評価とリーダーボードを使用する
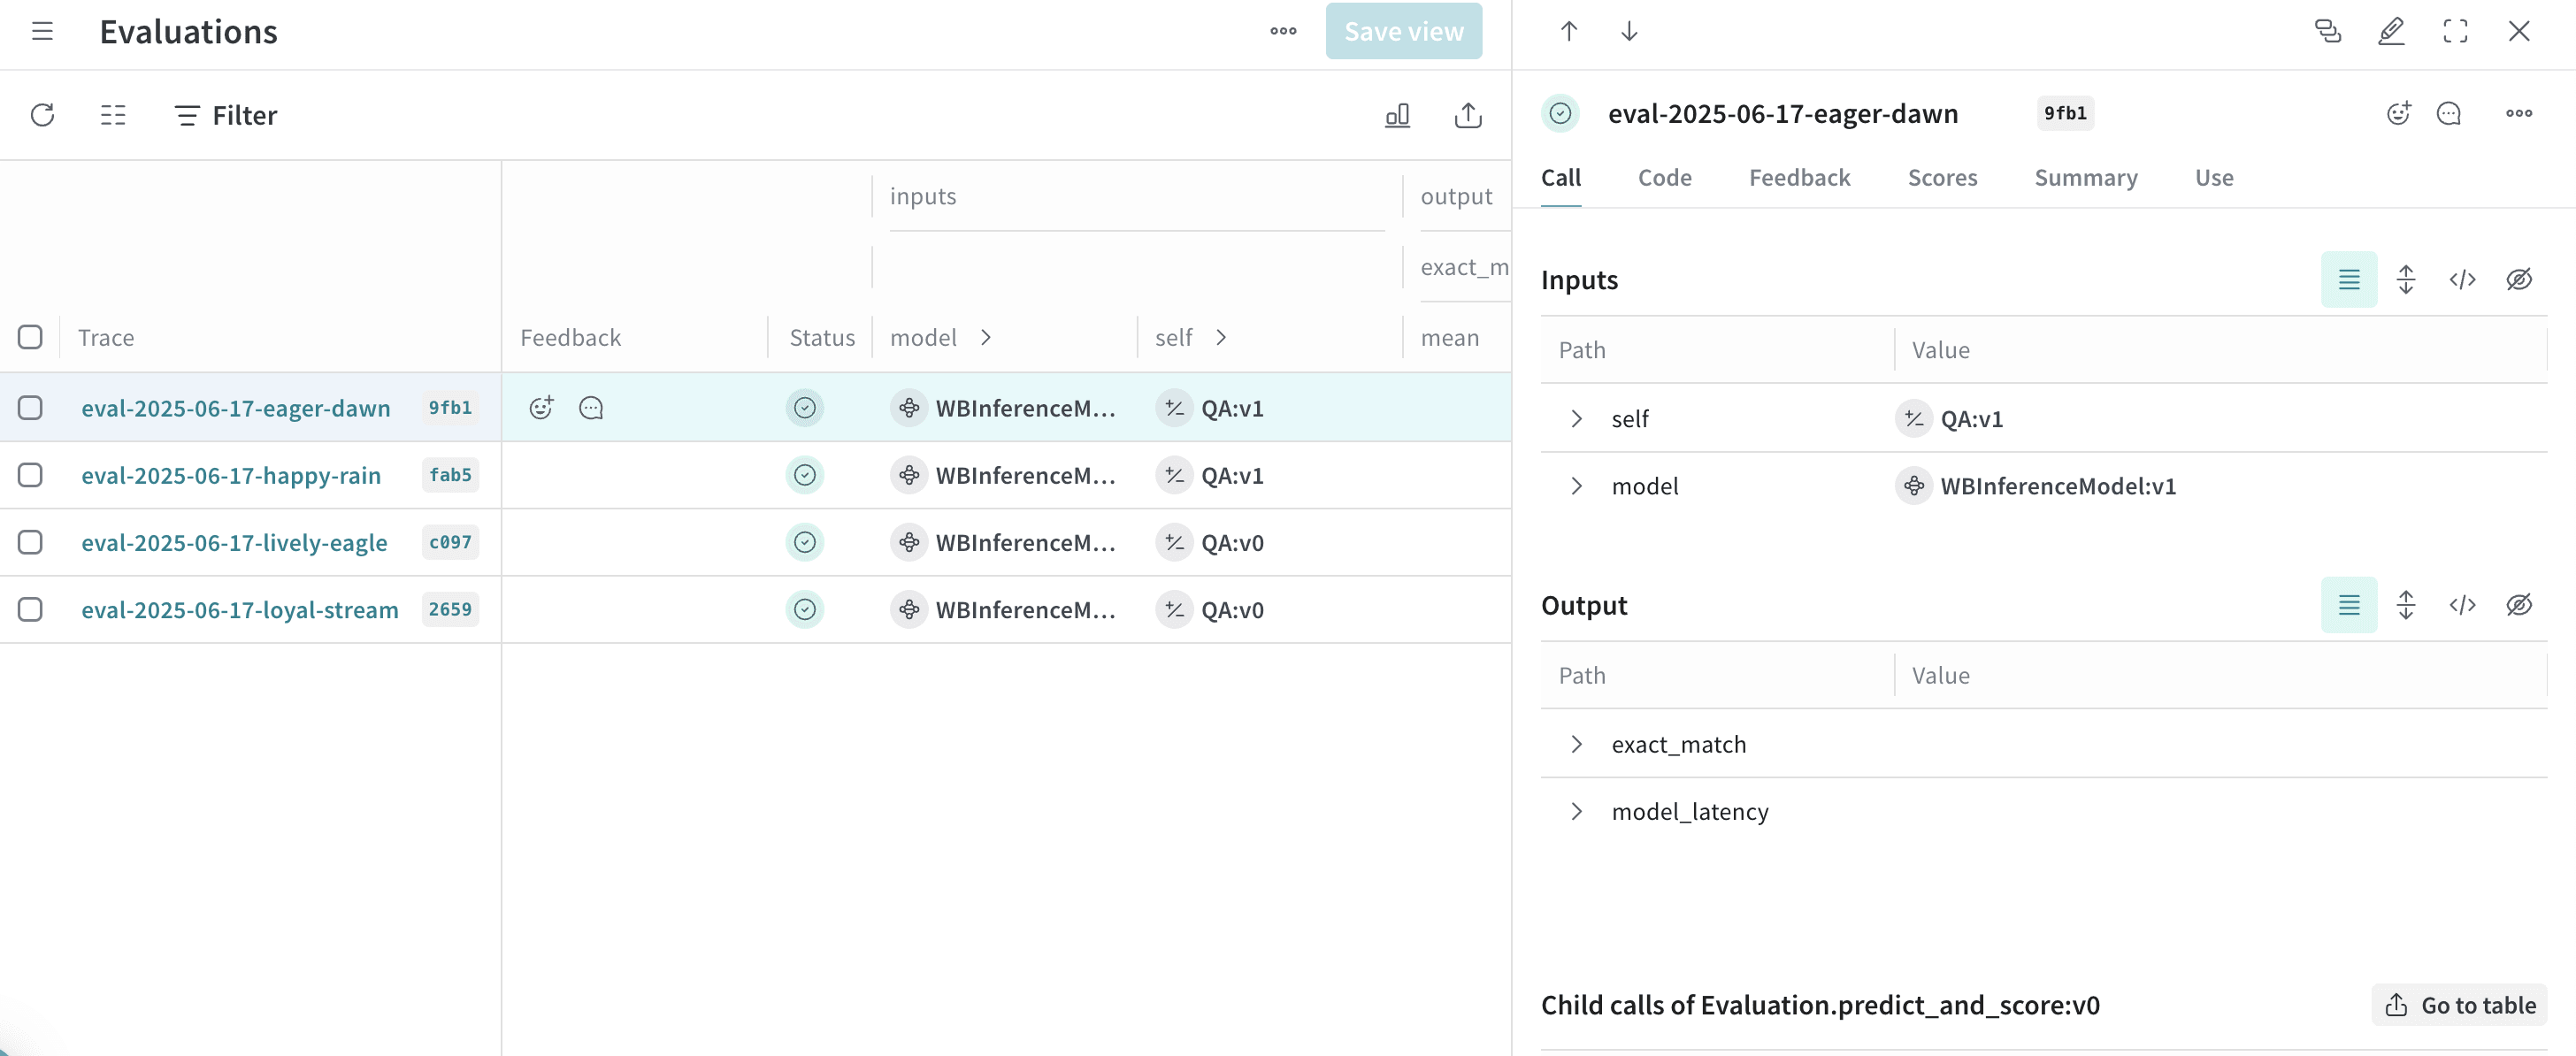
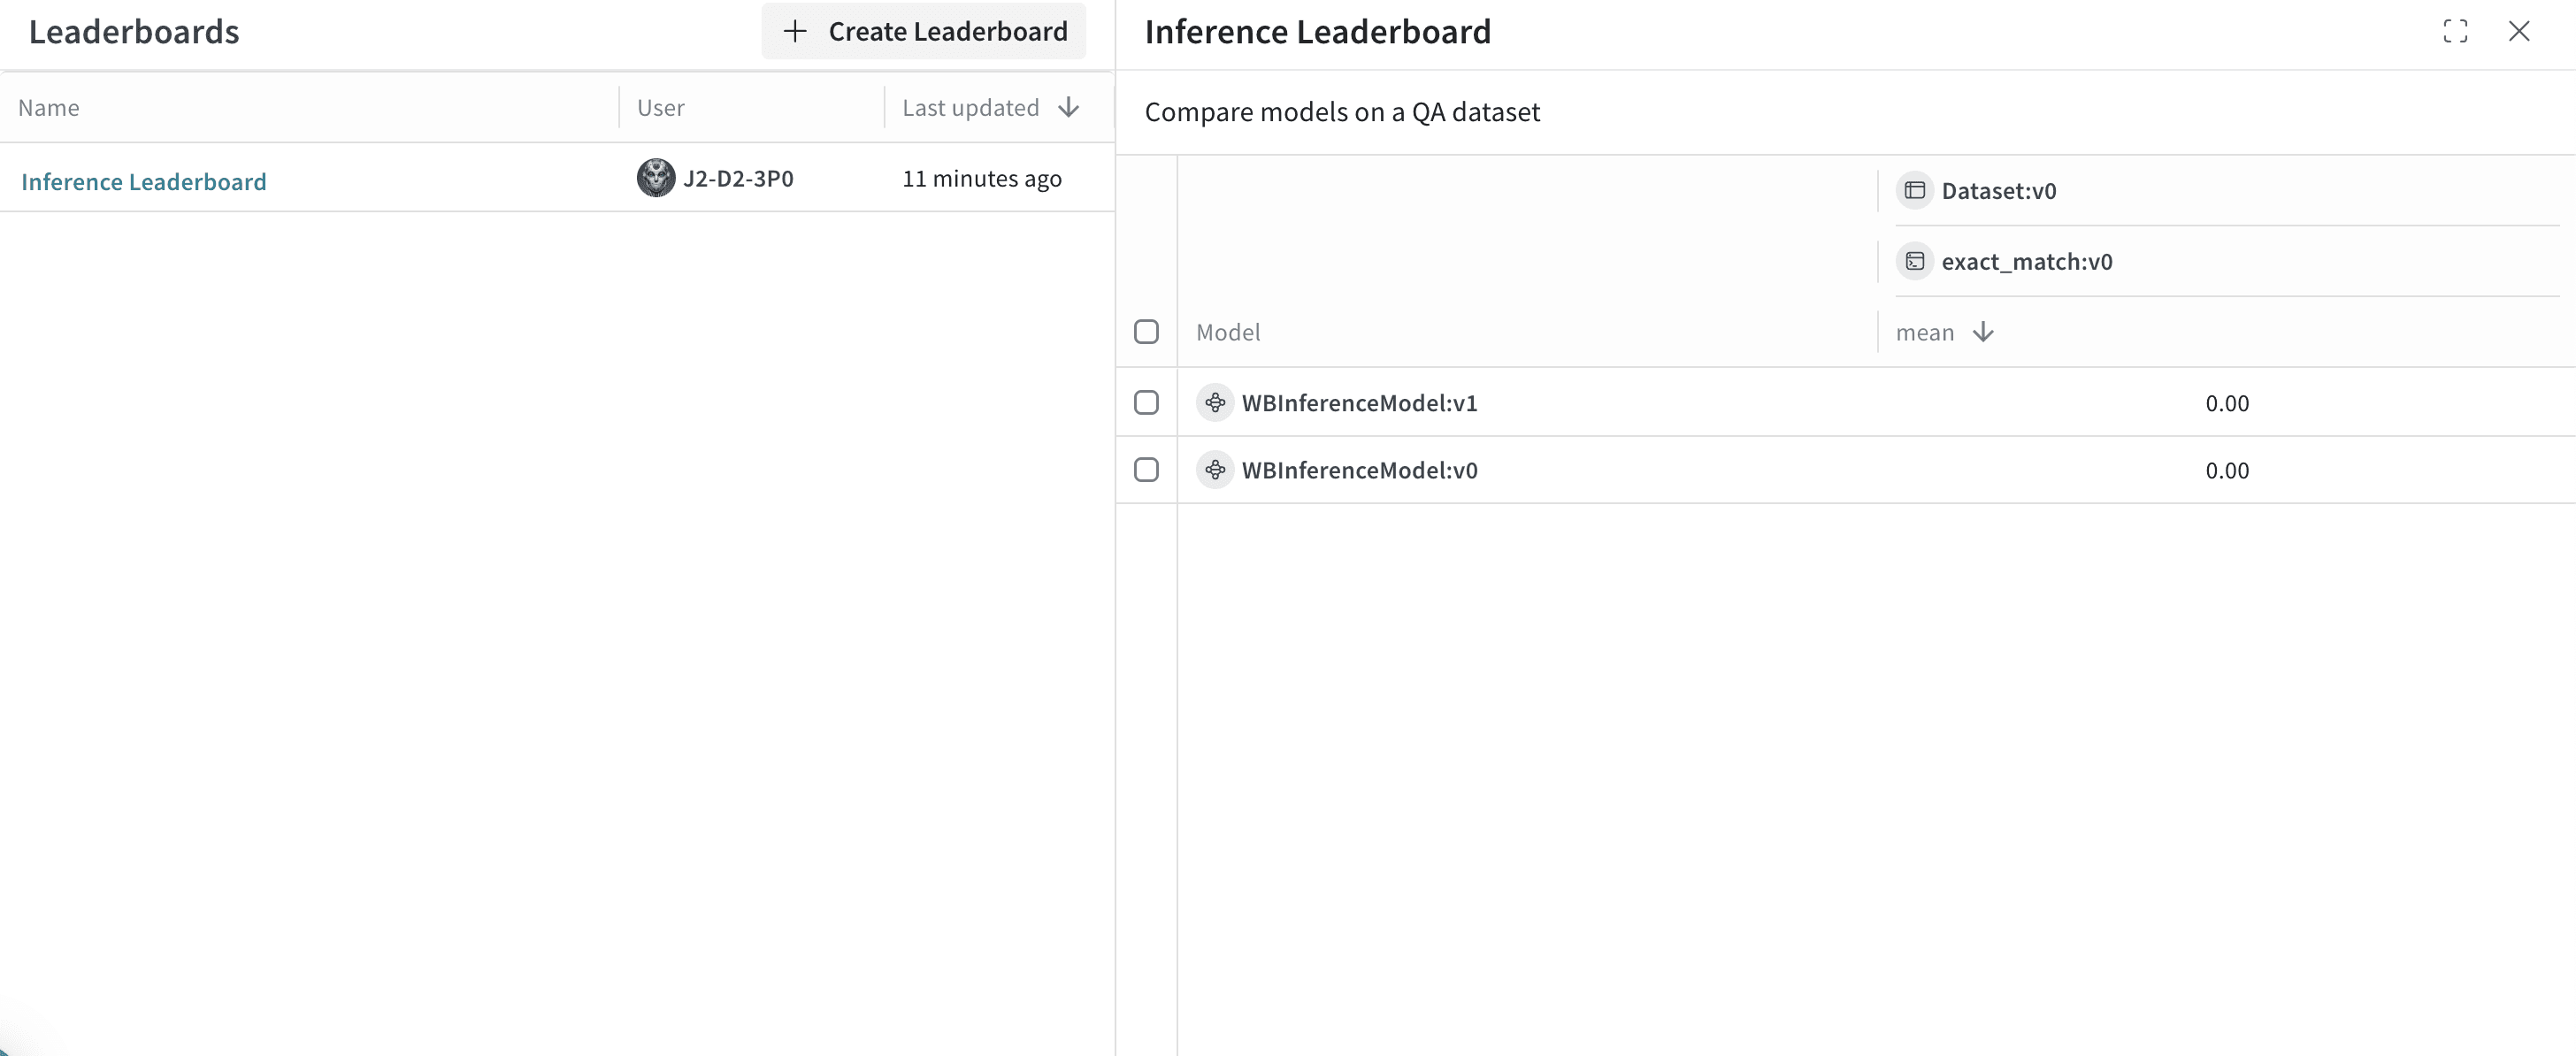
また、Inference サービス で Weave を使用してモデル Call をトレースし、パフォーマンスを評価し、リーダーボードを公開することもできます。次の Python コードサンプルでは、質問応答データセットで 2 つのモデルを比較します。 この例を使用するには、一般的な前提条件とPython 経由で API を使用するための追加の前提条件を満たしている必要があります。- Traces タブにアクセスして、トレースを表示します。
- Evals タブにアクセスして、モデルの評価を表示します。
- Leaders タブにアクセスして、生成されたリーダーボードを表示します。
UI
以下のセクションでは、W&B UI で Inference サービスを使用する方法を説明します。UI で Inference サービスにアクセスする前に、前提条件を満たしてください。Inference サービスにアクセスする
Weave UI では、以下の場所から Inference サービスにアクセスできます。直接リンク
https://wandb.ai/inference にアクセスします。Inference タブから
- W&B アカウントにアクセスするには、https://wandb.ai/ を開きます。
- 左サイドバーから Inference を選択します。利用可能なモデルとその情報が表示されます。
Playground タブから
- 左サイドバーで Playground を選択します。Playground のチャット UI が表示されます。
- LLM のドロップダウンリストで Serverless Inference にカーソルを合わせます。右側に、使用可能な Serverless Inference モデルのドロップダウンが表示されます。
- Serverless Inference モデルのドロップダウンから、次の操作を行えます。
- 使用可能な任意のモデルの名をクリックして、Playground で試すことができます。
- Playground で複数のモデルを比較する。
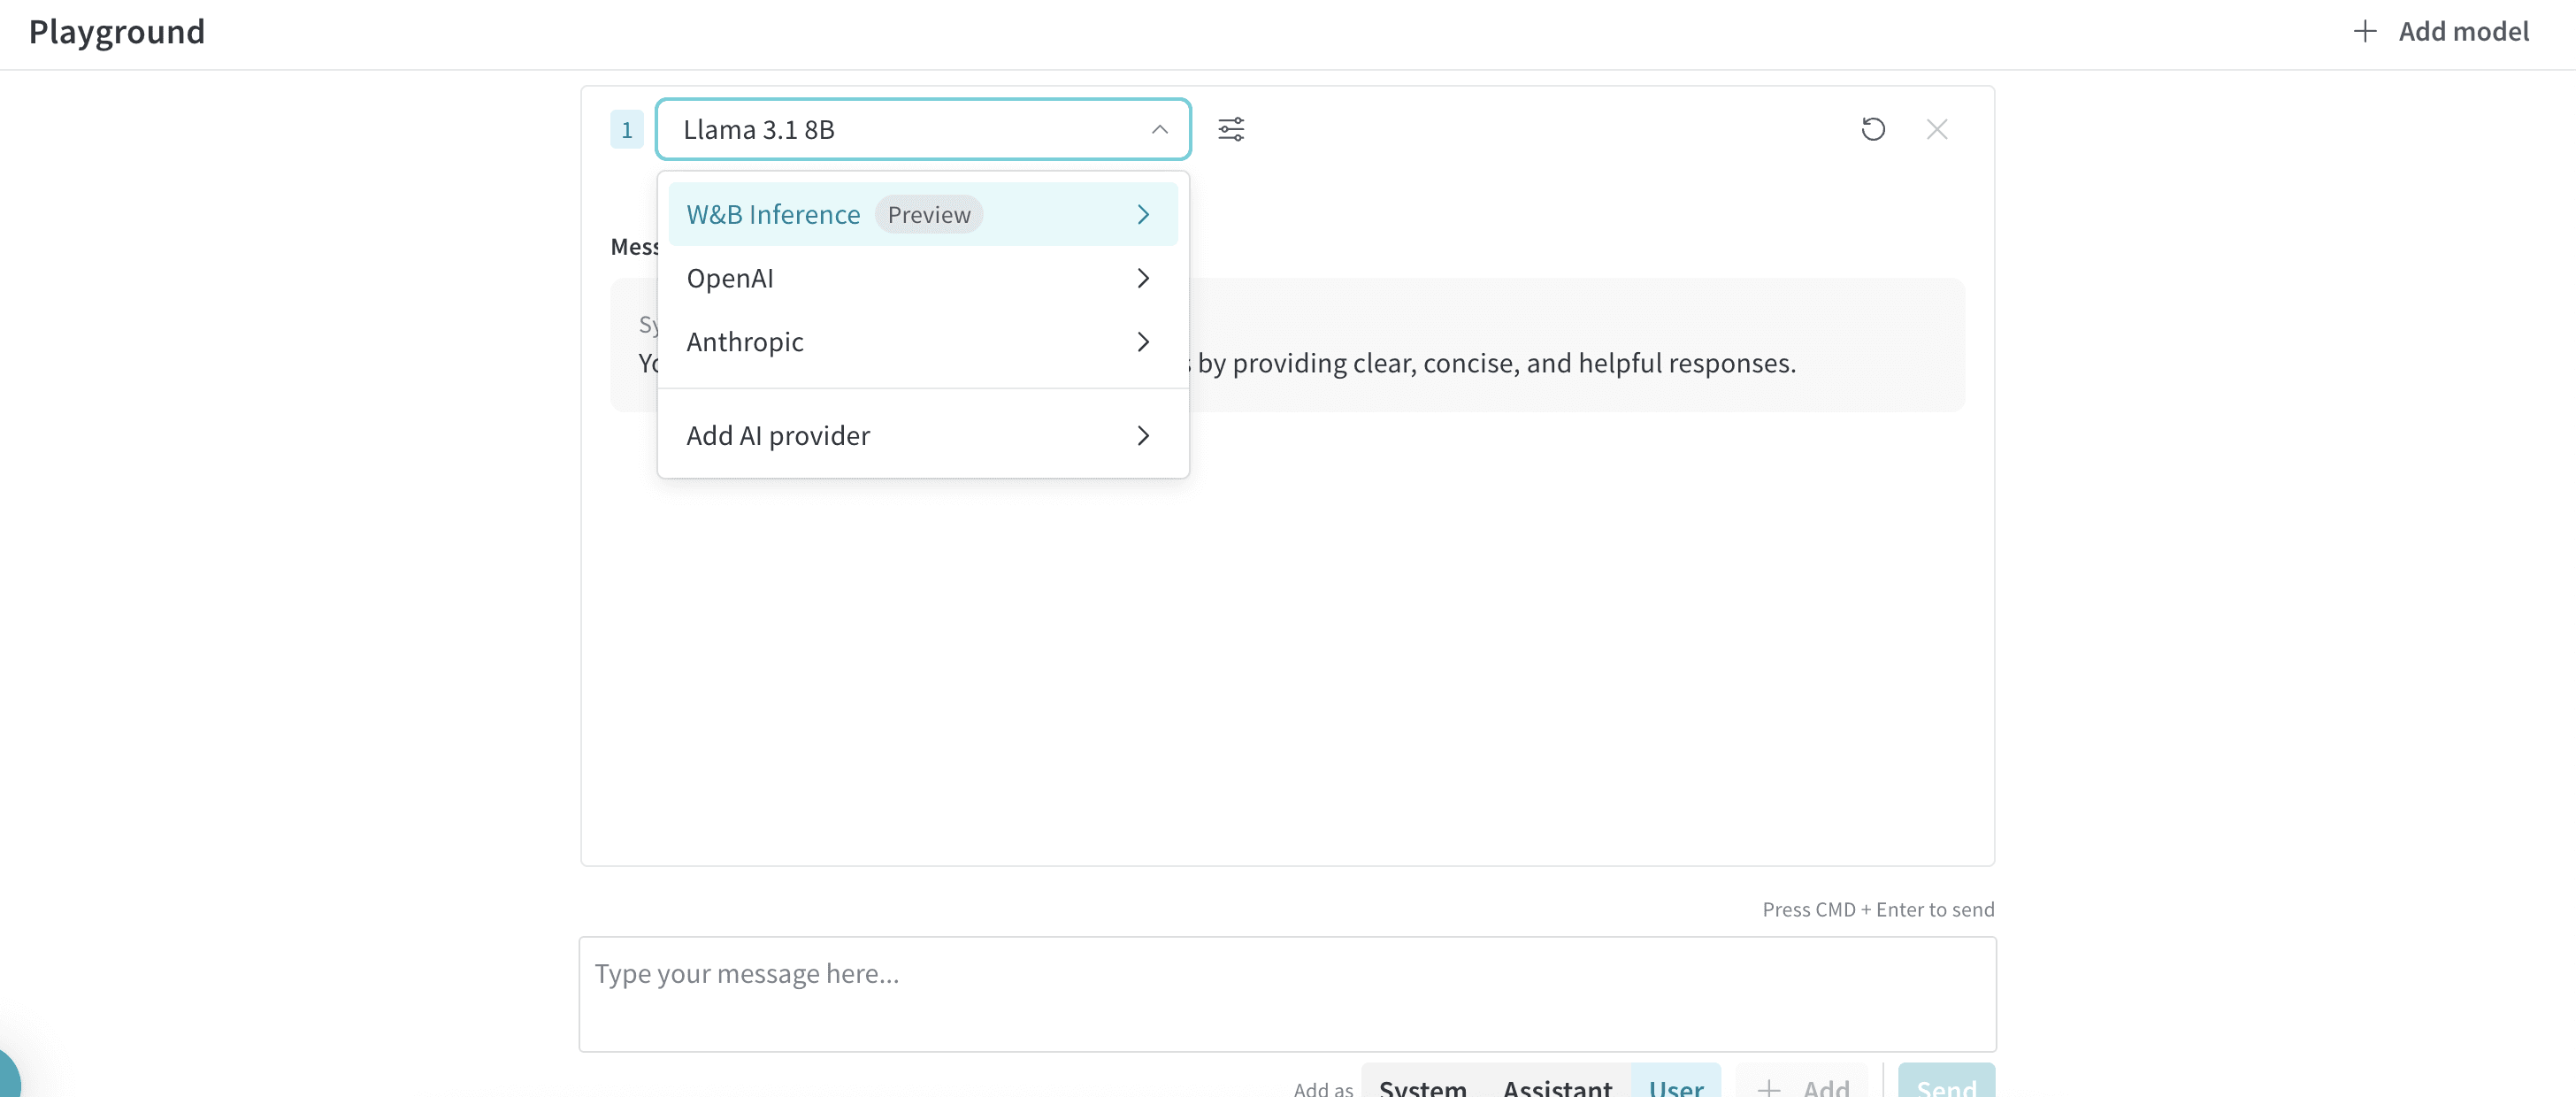
Playground でモデルを試す
いずれかのアクセス方法でモデルを選択したら、Playground でそのモデルを試せます。利用可能な操作は次のとおりです。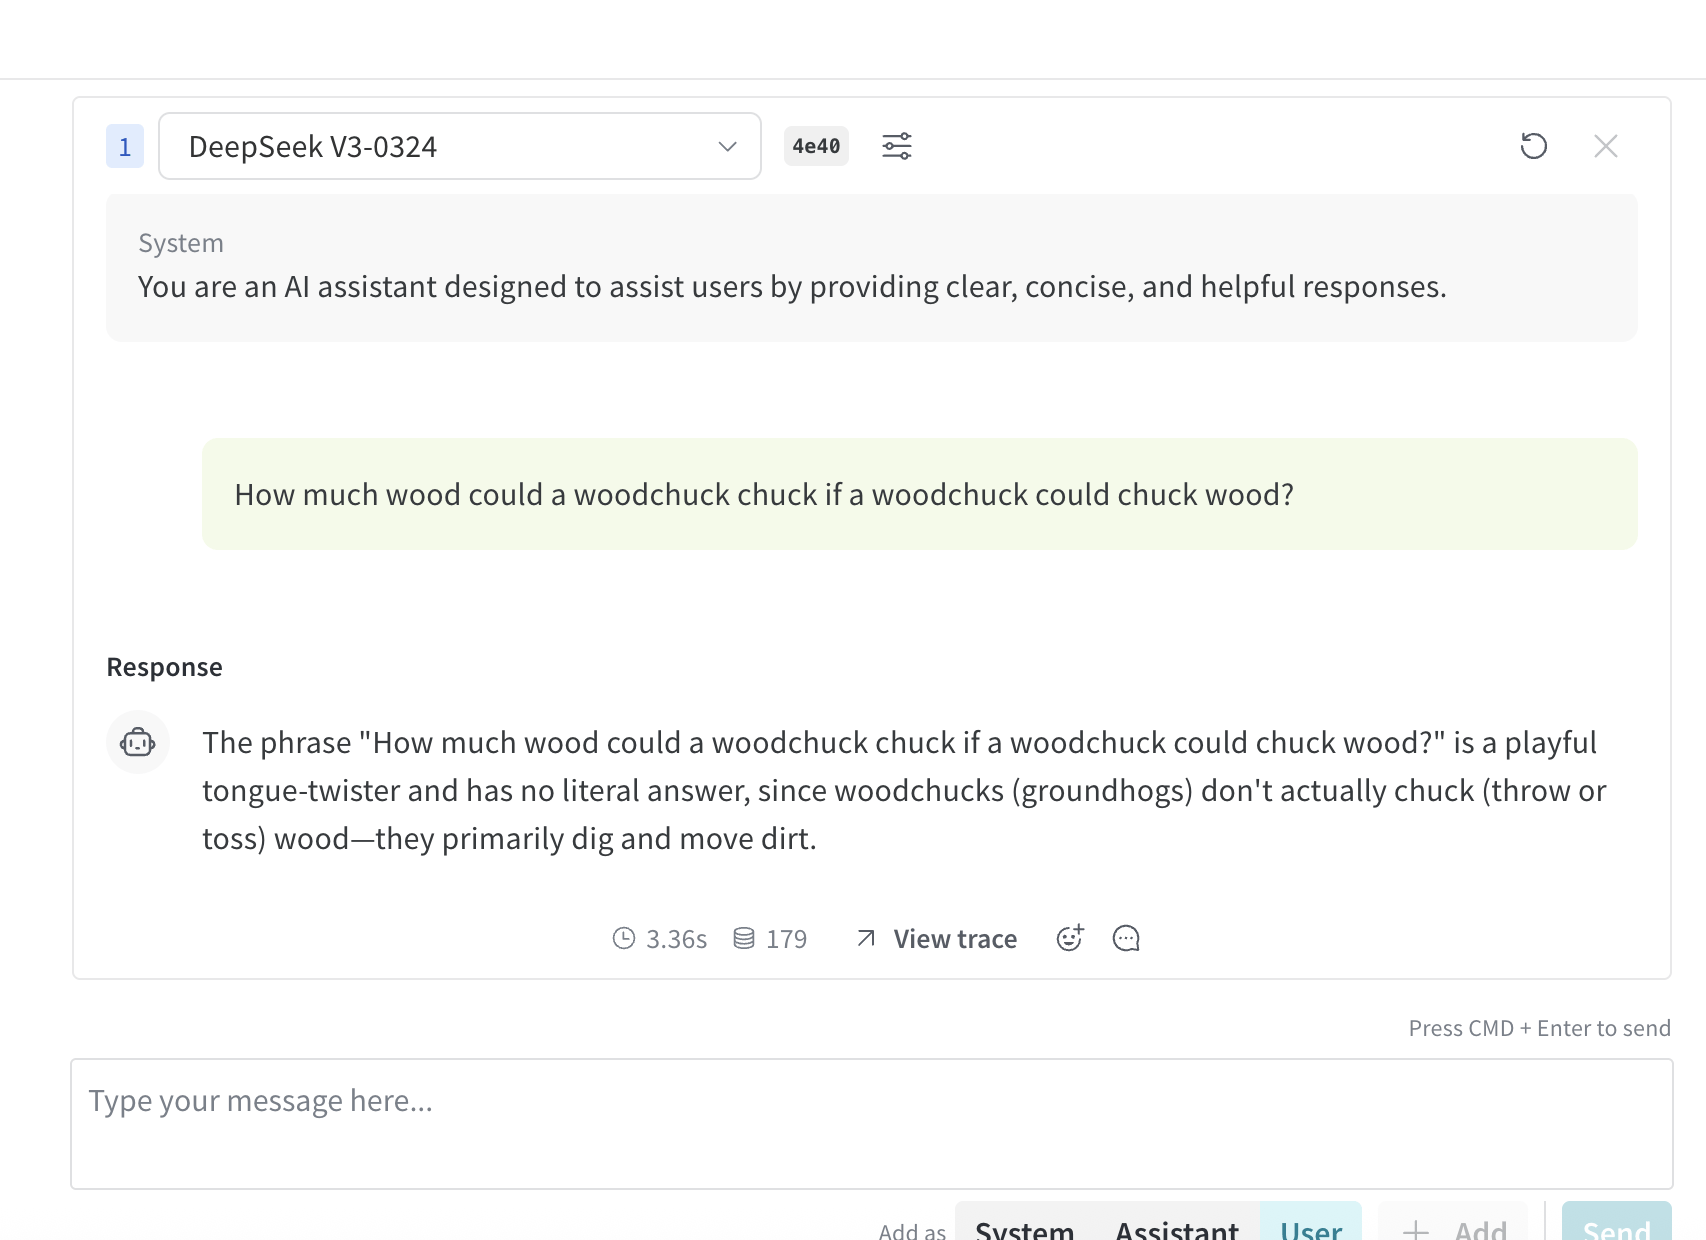
複数のモデルを比較する
Playground では、複数の Inference モデルを比較できます。Compare ビューには、次の 2 か所からアクセスできます。Inference タブから Compare ビューにアクセスする
- 左サイドバーで Inference を選択します。利用可能なモデルとモデル情報が表示されたページが開きます。
- 比較するモデルを選択するには、モデルカード上の任意の場所 (モデル名を除く) をクリックします。選択されると、モデルカードの枠線が青色で強調表示されます。
- 比較したい各モデルについて、step 2 を繰り返します。
- 選択したいずれかのカードで、Compare N models in the Playground ボタンをクリックします (
Nは比較するモデル数です。たとえば、3 つのモデルを選択した場合、ボタンには Compare 3 models in the Playground と表示されます)。比較ビューが開きます。
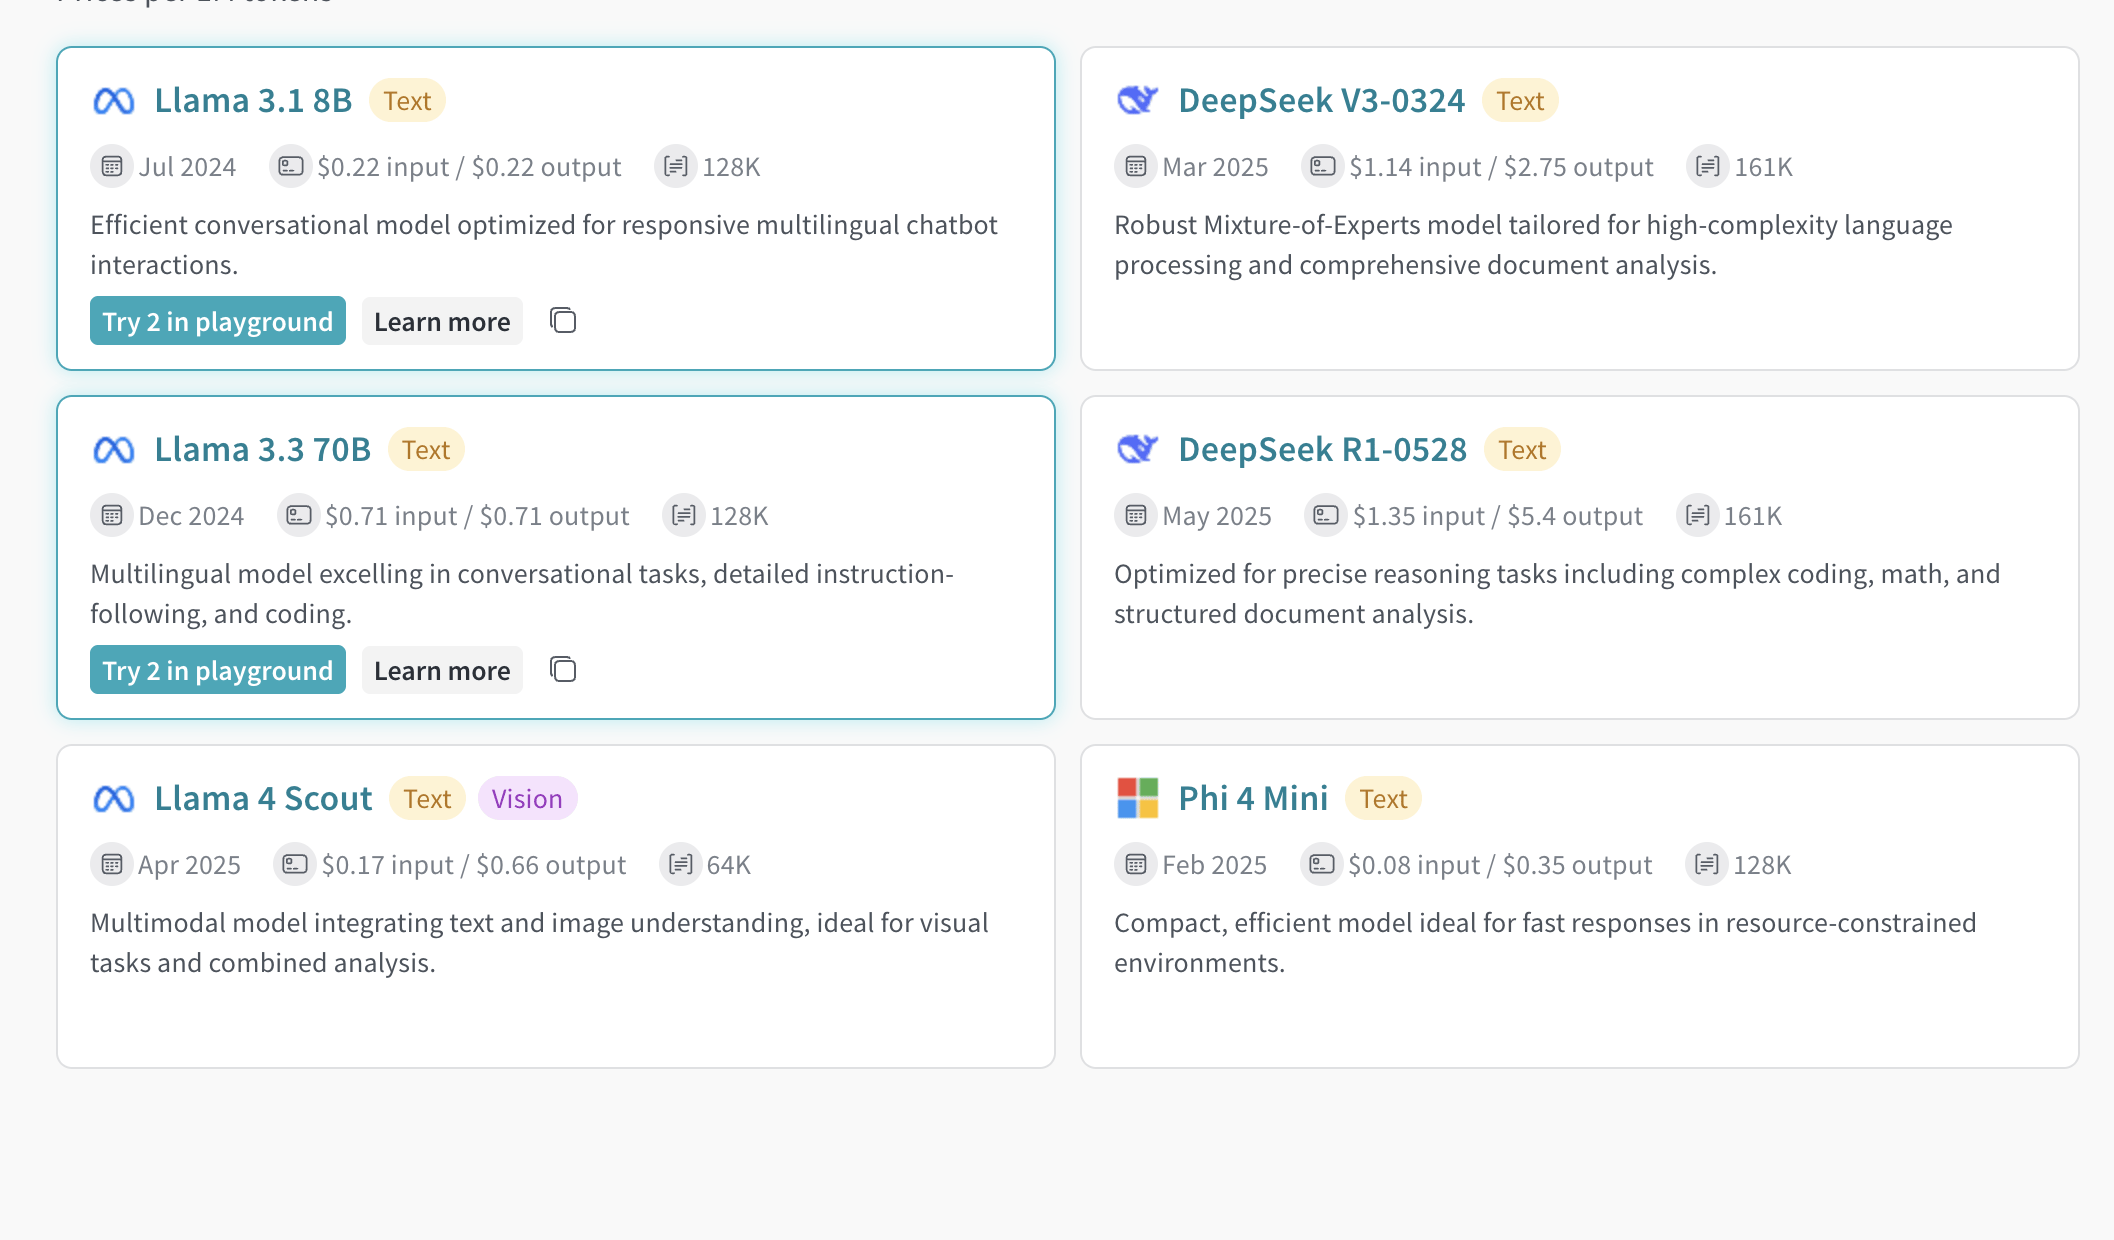
Playground タブから Compare ビュー にアクセスする
- 左サイドバーで Playground を選択します。Playground のチャット UI が表示されます。
- LLM のドロップダウンリストで Serverless Inference にマウスオーバーします。右側に、利用可能な Serverless Inference モデルを含むドロップダウンが表示されます。
- ドロップダウンから Compare を選択します。Inference タブが表示されます。
- 比較するモデルを選択するには、モデルカード上の任意の場所 (モデル名を除く) をクリックします。選択されると、モデルカードの枠線が青色で強調表示され、選択されていることを示します。
- 比較する各モデルに対して step 4 を繰り返します。
- 選択したいずれかのカードで、Compare N models in the Playground ボタンをクリックします (
Nは比較するモデル数です。たとえば、3 つのモデルを選択した場合、ボタンには Compare 3 models in the Playground と表示されます) 。comparison view が開きます。
請求と使用状況の情報を表示する
組織管理者は、現在の Inference クレジット残高、使用履歴、今後の請求額 (該当する場合) を W&B UI から直接確認できます。- W&B UI で、W&B の Billing ページにアクセスします。
- 画面右下に Inference の請求情報カードが表示されます。ここでは、次のことができます。
- Inference の請求情報カードにある View usage ボタンをクリックして、経時的な使用状況を確認します。
- 有料プランをご利用の場合は、今後の Inference の請求額を確認します。
利用に関する情報と制限
以下のセクションでは、地理的制限、同時実行制限、料金など、利用に関する重要な情報と制限について説明します。サービスを利用する前に、この情報をあらかじめ確認してください。地理的制限
Inference サービスは、サポート対象の地域からのみ利用できます。詳細は、Terms of Serviceを参照してください。同時実行制限
公平な利用と安定したパフォーマンスを確保するため、Serverless Inference API では、ユーザー単位および project 単位でレート制限を設けています。これらの制限には、次の目的があります。- 不正利用を防ぎ、API の安定性を保つ
- すべてのユーザーが利用できるようにする
- インフラストラクチャーの負荷を効果的に管理する
429 Concurrency limit reached for requests レスポンスを返します。このエラーを解消するには、同時リクエスト数を減らしてください。