

- 모델 성능 저하 추적.
- 공유 평가 워크플로 조율.
리더보드 생성은 Weave UI와 Weave Python SDK에서만 지원됩니다. TypeScript 사용자는 Weave UI를 사용해 리더보드를 생성하고 관리할 수 있습니다.
리더보드 만들기
Weave UI 또는 프로그래밍 방식으로 리더보드를 만들 수 있습니다. 일회성 비교에는 UI 방식을 선택하고, 자동화된 평가 워크플로에 리더보드 생성을 통합하려면 Python SDK를 사용하세요.UI 사용
Weave UI를 사용해 대화형으로 리더보드를 만들고 사용자 지정하려면 다음과 같이 하세요.- Weave UI에서 Leaders 섹션으로 이동합니다. 보이지 않으면 More → Leaders를 클릭합니다.
- + New Leaderboard를 클릭합니다.
- Leaderboard Title 필드에 설명적인 이름(예:
summarization-benchmark-v1)을 입력합니다. - 필요에 따라 이 리더보드에서 무엇을 비교하는지 설명하는 내용을 추가합니다.
- 표시할 평가와 메트릭을 정의하려면 열 추가를 수행합니다.
- 레이아웃이 준비되면 리더보드를 저장하고 게시하여 다른 사람과 공유합니다.
열 추가
열은 각 모델별로 리더보드에 표시할 내용을 정의합니다. 리더보드의 각 열은 특정 평가의 메트릭을 나타냅니다. 열을 설정하려면 다음을 지정합니다.- 평가: 드롭다운에서 평가 run을 선택합니다(미리 생성되어 있어야 함).
- Scorer: 해당 평가에 사용된 채점 함수(예:
jaccard_similarity또는simple_accuracy)를 선택합니다. - 메트릭: 표시할 summary 메트릭(예:
mean또는true_fraction)을 선택합니다.
- 앞이나 뒤로 이동. 열 순서를 변경합니다.
- 복제. 열 정의를 복사합니다.
- 삭제. 열을 제거합니다.
- 오름차순 정렬. 리더보드의 기본 정렬을 설정합니다(다시 클릭하면 내림차순으로 전환됨).
Python SDK 사용
코드에서 리더보드를 정의, 게시, 조회하려면 Python SDK를 사용하세요. 이 방식을 사용하면 평가 코드와 함께 리더보드 버전을 관리하고 자동화된 워크플로의 일부로 실행할 수 있습니다. 리더보드를 생성하고 게시하려면 다음과 같이 하세요.-
테스트 데이터셋을 정의합니다. 기본 제공
Dataset을 사용하거나, 입력과 타깃 목록을 직접 정의할 수 있습니다: -
하나 이상의 scorers를 정의합니다:
-
Evaluation을 생성합니다: -
평가할 모델을 정의합니다:
-
평가를 실행합니다:
-
리더보드를 생성합니다:
-
리더보드를 게시합니다.
-
결과를 조회합니다:
End-to-end Python 예제
다음 예제에서는 Weave Evaluations를 사용해 맞춤형 메트릭으로 공유 데이터셋에서 세 가지 요약 모델을 비교하는 리더보드를 만듭니다. 작은 벤치마크를 만든 뒤 각 모델을 평가하고, Jaccard similarity로 각 모델의 점수를 매긴 다음, 결과를 Weave 리더보드에 게시합니다.리더보드 보기 및 해석
스크립트가 리더보드를 게시한 후에는 Weave UI에서 결과를 확인하고 모델 성능을 나란히 비교합니다:- Weave UI에서 Leaders 탭으로 이동합니다. 보이지 않으면 More를 클릭한 다음 Leaders를 선택합니다.
- 리더보드 이름(예:
Summarization Model Comparison)을 클릭합니다.
model_humanlike, model_vanilla, model_messy)을 나타냅니다. mean 열은 모델의 출력과 레퍼런스 요약 간의 평균 Jaccard 유사도를 보여줍니다.
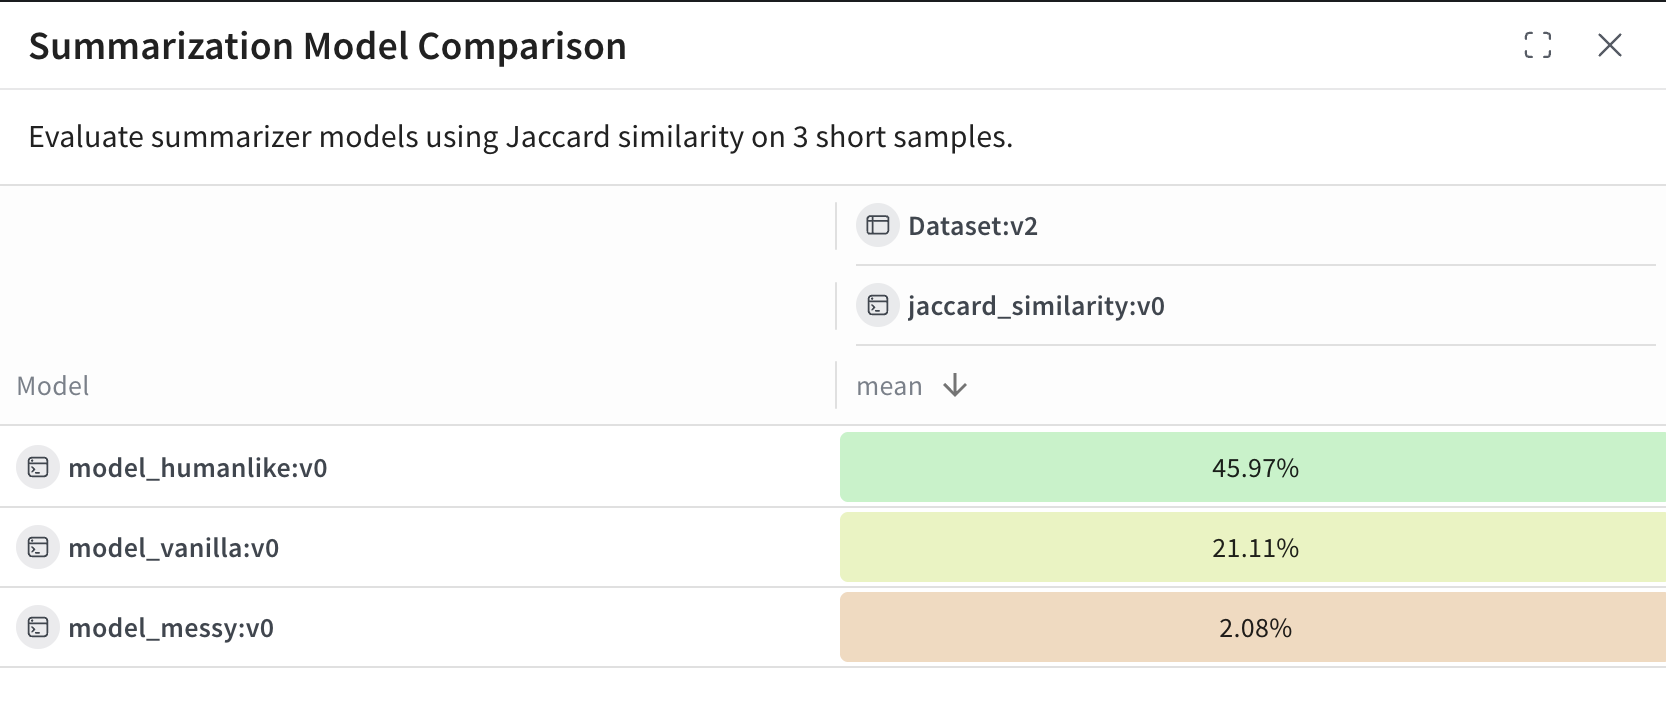
model_humanlike가 약 46퍼센트의 중첩률로 가장 좋은 성능을 보입니다.model_vanilla(단순한 잘라내기 방식)는 약 21퍼센트를 기록합니다.model_messy는 의도적으로 성능이 나쁘게 만든 모델로, 약 2퍼센트의 점수를 기록합니다.